巨头砍价是真的,赢麻了也是真的,可惜两件事算不到一处去。
最近这段时间,AI圈里同时跑了三条消息,虽然彼此都有热度,但看上去各在各的频道里。
一条是北美三巨头突然的集体降价。OpenAI、谷歌、Anthropic在九天之内,把主力模型的报价大幅削减,并且撞到了同一个数字上——输入2美元、输出10美元。
另一条是网上疯传的一种说法:中国55%的AI Token消耗都拿去拍AI短剧了,美国那边主要用来写代码。于是有人总结,“AI时代中国人又一次把火药做成了烟花”。
至于最后那条,国内某家头部模型公司的识图功能,把自家创始人的照片认成了另一位著名的赛博谐星,还答得相当笃定。不过呢,这条已经流传了三四个月之久,但一直有热度,而且不断出新哏。
这三条单独看都成立,摆在一起却互相拆台。
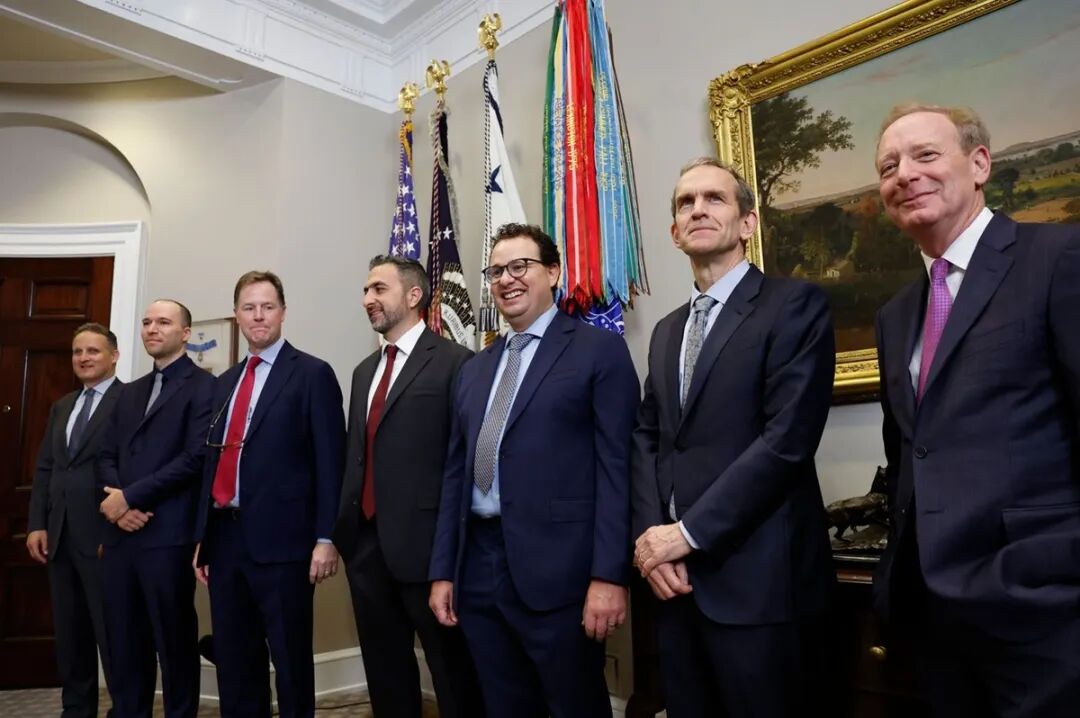

▲ 美国AI巨头们,最近日子不太好过
如果中国模型真的只会拍短剧,美国巨头犯不着在同一周里集体降价应战。如果价格优势真到了逼对手贴钱抢人的地步,那55%这种消耗结构也不该被当成落后的证据。至于第三条,它既不支持前面的自豪,也不支持后面的嘲讽。
三条消息指向的是同一件事的不同侧面,而每一条在传播时都只截取了对自己有利的那一段。
降价警告!
9月22日,OpenAI发布GPT-6 Sol和GPT-6 Luna,每百万Token的报价分别是输入2美元、输出10美元,以及输入0.1美元、输出0.5美元。官方给的对照基准是上一代GPT-5.6 Sol的促销价4美元和20美元,等于再砍一半。
10月1日谷歌跟上。Gemini 4 Argon报出输入2美元、输出10美元,同时把单次输出上限从前代的64K直接拉到100万Token。Anthropic的Claude Sonnet 5.5随后也落在2和10这两个数字上。
说句题外话,很多人认为Anthropic的CEO达里奥·阿莫迪有严重的种族歧视和反华倾向。但笔者必须给达里奥正名,他并不是反华,只是更纯粹地反人类“而已”。这正如Anthropic这个名字的含义,虽然一般理解为“与人类有关的”或者学术上的“人择原理”,但笔者以为“拟人的”似乎更加合适
九天之内,三家互相盯着对方的报价页面,最后精确撞在同一个价格上。但往下还有更狠的。
10月7日Anthropic发布Haiku 5.5,10万Token以内的请求输入0.1美元、输出0.5美元,正好是上一代Haiku 4.5的十分之一,也和OpenAI的GPT-6 Luna完全持平。同一天OpenAI把GPT-6放进ChatGPT,付费档用Sol,免费档和Go档用Luna。
各家公告里没写降价原因,但其实一切明摆着。过去两年中国开源模型把全球价格带压到了一个极低的位置,第三方评测机构Artificial Analysis给出的口径是,DeepSeek V4 Flash跑完一次基准任务的平均成本0.03美元,Anthropic旗舰Claude Fable 5要3.15美元,差了一百倍。
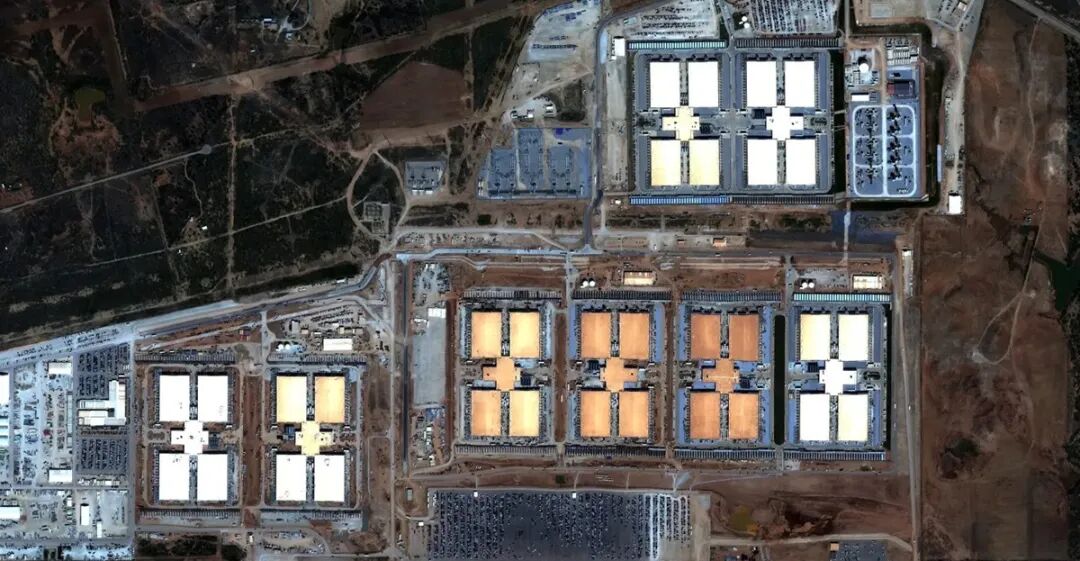
▲ 星际之门计划在全美建设的多个算力中心之一。仅照片里这个(位于德州),建筑和硬件投入就接近百亿美元规模
美国开发者社群里,甚至为此生造了个词叫Chinamaxxing,意思是不遗余力地把能换的管道都换成中国模型。有创业者算过,付费用户从五千涨到五万,三个月就能把融资烧光,于是先换模型再谈扩张。
所谓斩杀线说的就是这条线。能力跟别人差不多、价格却高出一截的模型,会先失去规模化使用的理由。
只是这轮价格里有一大半是带期限的。
谷歌的推广价明写到11月30日,12月1日起翻倍到输入4美元、输出20美元,Gemini 3.8 Flash则是2027年1月1日起翻倍。Haiku 5.5的价格表上有个10万Token的分界线,超过之后直接跳到5倍。
OpenAI这边虽然由产品负责人出面说GPT-6是永久价而非促销价,但旗舰Astra的标准价是输入10美元、输出50美元,作为纵向对比,2025年7月的GPT-5输出价是20美元,2026年3月的GPT-5.4是15美元。旗舰档这一路是往上走的,掉下来的只有中低端那几档。
也就是说,这轮降价砍的是标价,不是算力成本。砍得动的部分,说明那部分成本本来就薄。
赢学警告!
价格战打到这个份上,另一边的舆论场上却冒出了一条方向完全相反的消息。
最近被翻出来热传的一组数据是,中国55%的AI Token消耗流向了AI短剧和视频生成,电商与营销占24%,软件开发只有15%。配上美国那边编程研发和企业自动化占大头的说法,结论顺理成章,AI时代中国人又一次“把火药做成了烟花”。
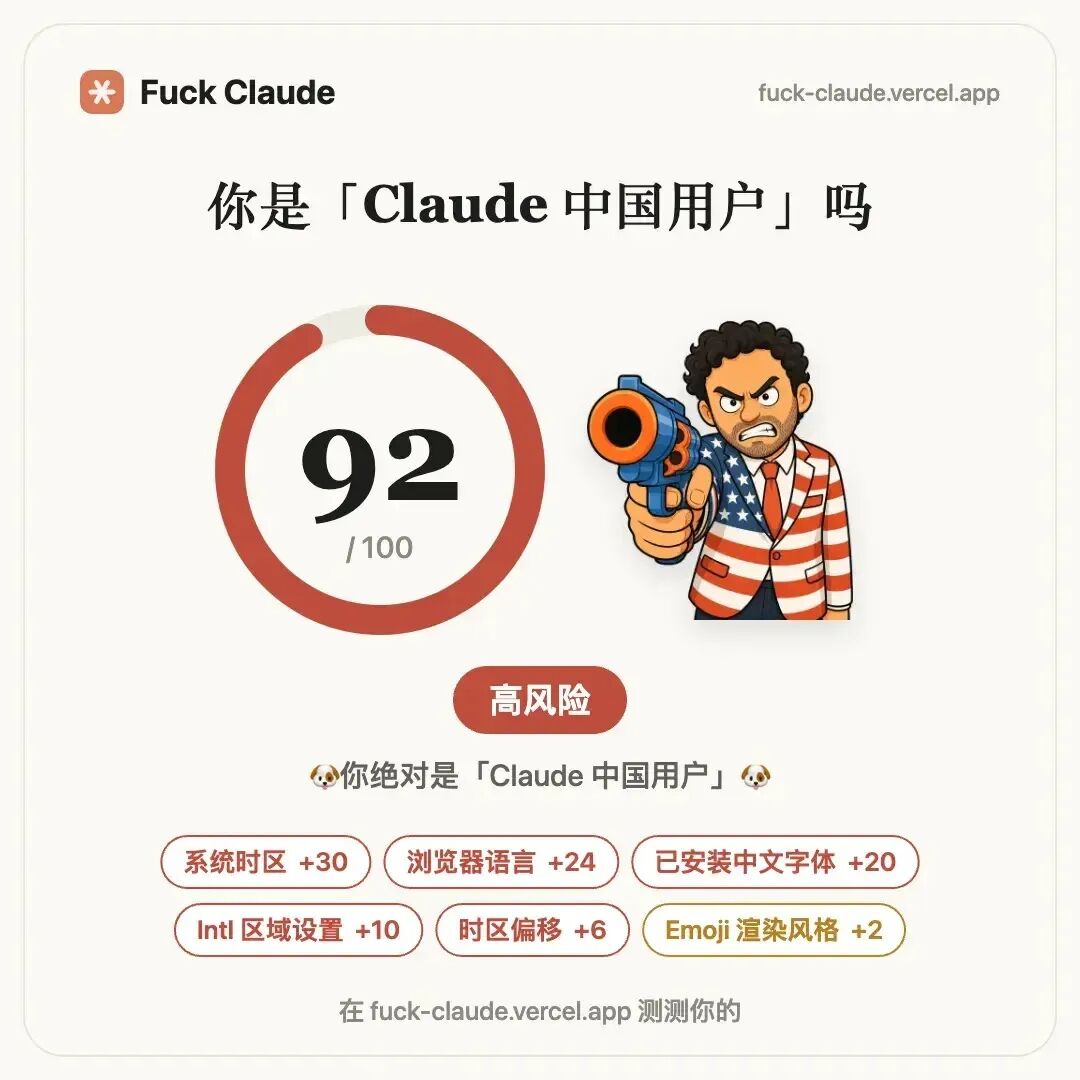
▲ 说句题外话,Claude最近小半年来对中国用户采取发现即封号的极端政策,已引起了不止中国用户在内的多方不满,有好事之人再GitHub上开源了一个小工具叫FuckClaude,让你在浏览器里一键自测,自己的环境到底有多像 Claude Code 眼中的中国用户
这组数字的出处得先交代清楚。其来自中文在线6月3日的一场机构投资者交流,是公司单方披露,既不是国家统计部门的口径,也不是第三方独立机构的普查。中文在线没有公开说明统计方法、覆盖了哪些模型平台,以及不同模态之间Token怎么换算。
流传最广的那句表述还偷换了计量单位。原始表述是AI短剧与视频生成合计55%,被一路压缩成了AI短剧单独55%。
视频Token和文本Token根本不是一个量级,720p下一条5秒镜头大约烧10万Token,跟一部十万字的剧本相当。一部90分钟的AI短剧,光成片就约1.1亿Token。再加上行业里普遍的抽卡,一个镜头平均重跑三四次,单部实际消耗轻松破亿。文本侧是十万级,视频侧是亿级,中间差三到四个数量级。这个比例很大程度是视频本身的算力密度决定的,不是谁把资源都拿去拍霸总了。
当然,更为重要的是,经过裁剪后被忽略掉的总量数字。
OpenRouter的周度数据里,3月30日到4月5日中国模型调用量12.96万亿Token,美国3.03万亿,中国是美国的四倍多。到10月5日至11日那周,中国86.74万亿,环比涨50.96%,已经连续二十四周超过美国,全球调用量前五全是中国模型。
把四倍和55%放在一起算,中国光是投在AI短剧上的Token,就已经接近美国Token总消耗的两倍。就算把短剧整个扣掉,剩下的45%乘上四倍,也还是美国总消耗的一点八倍。
一边是四倍,一边是55%,两个数字出自同一批统计,但只有后者被拿去到处传。消耗总量不利于某种叙事,那就只把比例拿出来说事。这条消息的全部生产逻辑就在这里。
顺带说一句,这个行业自己也在把重跑当成本事。中文在线的原话是,哪家公司的作品精细度与Token消耗更具规模,哪家就越能形成技术与资源壁垒。仿真人剧对帧数和1080p要求更严,消耗是720p漫剧的两到三倍,于是更高清等于更烧钱等于更强护城河。一家公司要重跑三四次才挑出一镜,另一家一次就成,后者效率是前者三到四倍,可在消耗量榜上前者反而更靠前。
脸盲警告!
比舆论场更值得看的,是这些模型实际能做到什么。
一张模糊的男性特写,黑短碎发,细框眼镜,嘴微张。识图模式盯着看了几秒,回答特征与网络流传的孙笑川直播截图及表情包高度吻合,指向性明确。
然而问题在于,照片里的人叫梁文锋,是深度求索的创始人。
有据可查的同类翻车确实有一串。过去几个月,澎湃、红星资本局、观察者网、钛媒体反复做过同一件事,把梁文锋的照片扔进识图框,答案依次是王兴、张一鸣、杨植麟、董宇辉、雷军、张小龙、王小川,还有一次是年轻版马化腾。有一回模型思考了几分钟,最后交代,我真的很不确定,不推荐猜测名字,因为猜错比说不知道更糟糕。
模型自己承认没有人脸识别模块,识别本质上是“读”而不是“看”。
梁文锋公开影像太少,训练数据里那张脸攒不出稳定特征,只能按统计相似度往最像的一堆人里扔。戴眼镜、中年、亚洲男性,三个标签一叠,中美两地的科技圈名字全落进同一个概率池。
而目前,类似的翻车还有不少。时代少年团的合照被判定为批量生成的AI假图,理由是皮肤过于光滑、提包有AI感。黄仁勋喝豆汁的照片认出了人,却把豆汁认成了牛奶。怀素草书七个字能错四个。
这类短板短期补不齐,原因是多模态的进步集中在能对齐标准答案的任务上,图表、文档、代码、空间推理,这些有明确的对错可供优化。人脸依赖长尾数据,进步慢得多。
技术局限是一面,另一面是家底。
腾讯罕见地公开承认整体算力严重不足,拖慢了混元迭代。DeepSeek的V4 Flash在8月因访问量超出预估导致API几乎不可用,随后宣布整体上调API定价,理由是算力紧张。Kimi K3爆火后被迫暂停C端新用户订阅去扩容。智谱一季度API涨价83%,调用量不降反升400%,供不应求的背后一样是算力不够。
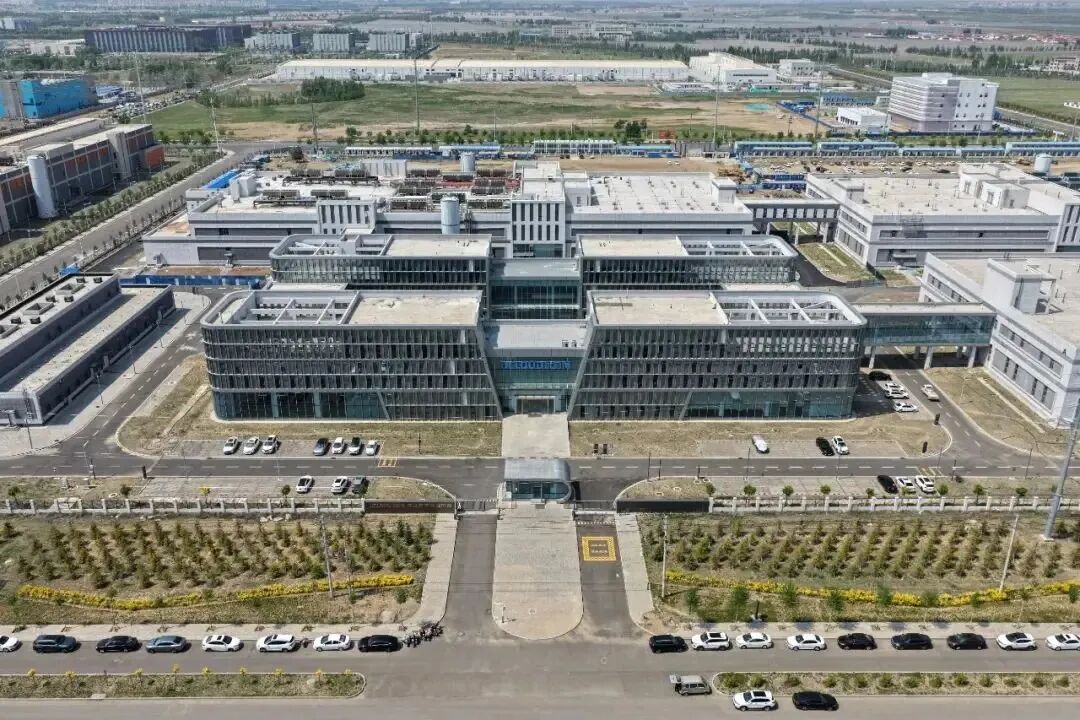
▲ 位于内蒙古乌兰察布的一处算力中心设施
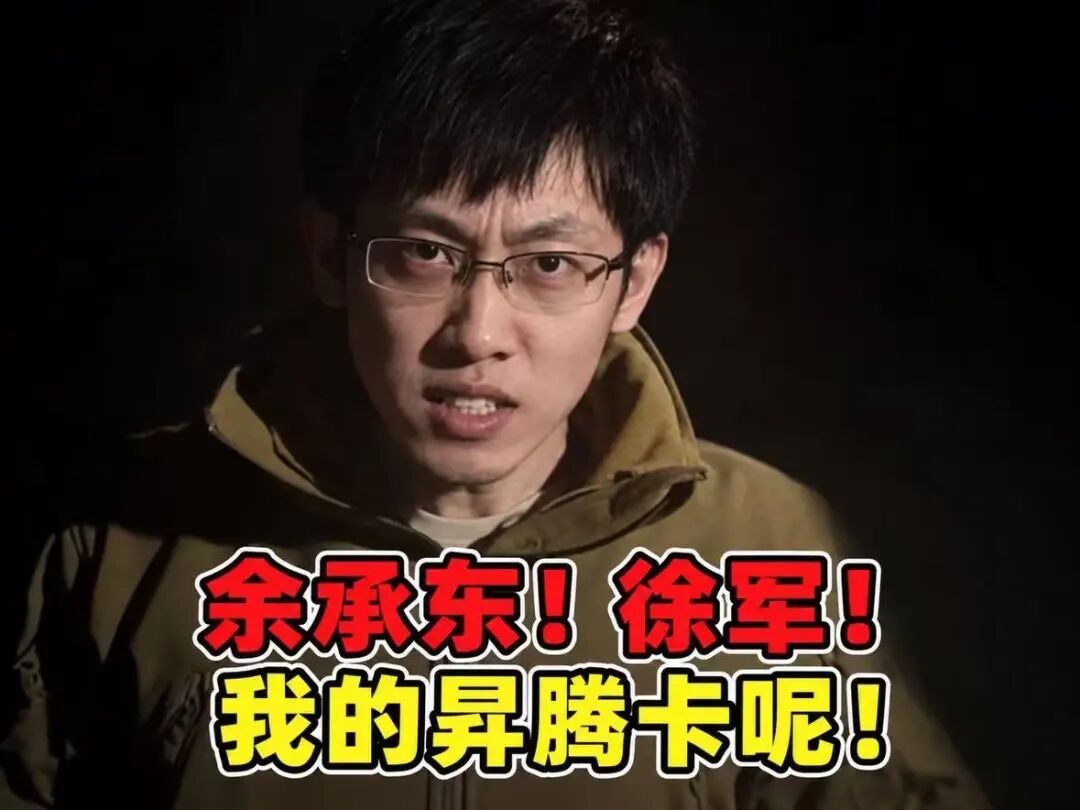
再往深里看,国内头部厂商至今把训练和推理分成两套家底。训练这种更重的活计,仍然依赖能拿到的那部分英伟达硬件,推理才逐步往国产卡上搬。华为轮值董事长徐直军说过一句实在话,今天制约昇腾放量的,已经不是需求,而是供货能力。
自主算力规模进场!
好在时值2026年10月,整个局面正在被一寸一寸地撬动。
华为昇腾384超节点在7月的WAIC上已经商用落地750多套,到9月全联接大会时,910C超节点的部署量超过1000套,累计在线卡时6.5亿,已有40多个大模型在昇腾上完成原生预训练。这是目前国内唯一跑出过SOTA模型的超节点路线。
7月9日,粤港澳大湾区首个国芯训国模的昇腾万卡智算集群在广东韶关上线,11520卡、9000P算力,从开工到投产只用了90天。美团发布LongCat-2.0时宣布,这个万亿参数模型已在五万卡国产算力集群上跑完从零预训练到推理的全流程。智谱建成了一座规划功率约1吉瓦、采用国产芯片的数据中心,部分设施已投入运营。更重的筹码排在后面。
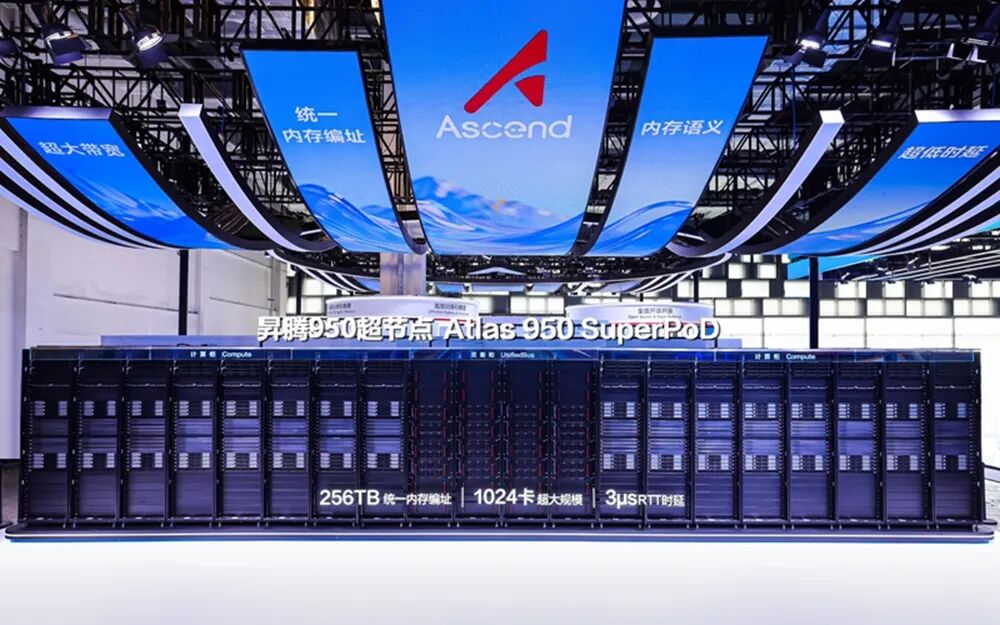
昇腾950超节点在WAIC首次真机亮相,1024卡规模,1 EFLOPS FP8算力,256TB全局统一内存编址,卡间时延3微秒,基于它打造的Atlas 950 SuperCluster可扩展到50万卡。昇腾960超节点引入全球首个量产NPO光引擎Hi-ONE,单引擎传输容量7.2T,可扩展至4096卡,多超节点组网最大可达51.2万卡。芯片节奏也在提速,960DT比原计划提前三个季度,2027年一季度就绪。
DeepSeek在内蒙古乌兰察布规划的智算中心是另一个标志性动作。这个1吉瓦级项目计划部署至少16万颗昇腾950DT,是有据可查的针对国产AI加速器规模最大的单笔承诺之一。一家模型公司把未来几年的算力押在同一款尚未量产的国产芯片上,这个动作本身就是态度。
软的一层也在补齐,9月底DeepSeek开源了面向昇腾的六个组件,包括被定位为CUDA替代方案的TileLang昇腾版。CANN开源社区已上线67个项目、1244万行代码,月活开发者从7月的3500人涨到9月的5000人以上,昇腾也在今年7月成为PyTorch官方支持的技术路线中唯一的中国硬件厂商。
IDC的报告显示,2026年上半年英伟达在中国数据中心AI芯片市场的份额降到34%,出货量67.8万颗、同比降44%,华为昇腾以57.2万颗拿到28%。两者差距从一年前的31个百分点缩到6个百分点。黄仁勋今年5月接受CNBC采访时承认,英伟达已基本把中国AI芯片市场让给了华为,并说对向中国销售先进芯片不要抱任何期待。伯恩斯坦的预测更激进,2026年英伟达在华份额8%,华为约50%。
昇腾的产能还卡在供货上,CANN的月活开发者离CUDA的规模也还差得远。但方向已经清楚了。等这些算力真正铺开,等到我们的训练不必再看别人的脸色……北美三巨头才能更加愉快地打它们的价格战,而且想打多久就打多久!